Publié le 2026-08-20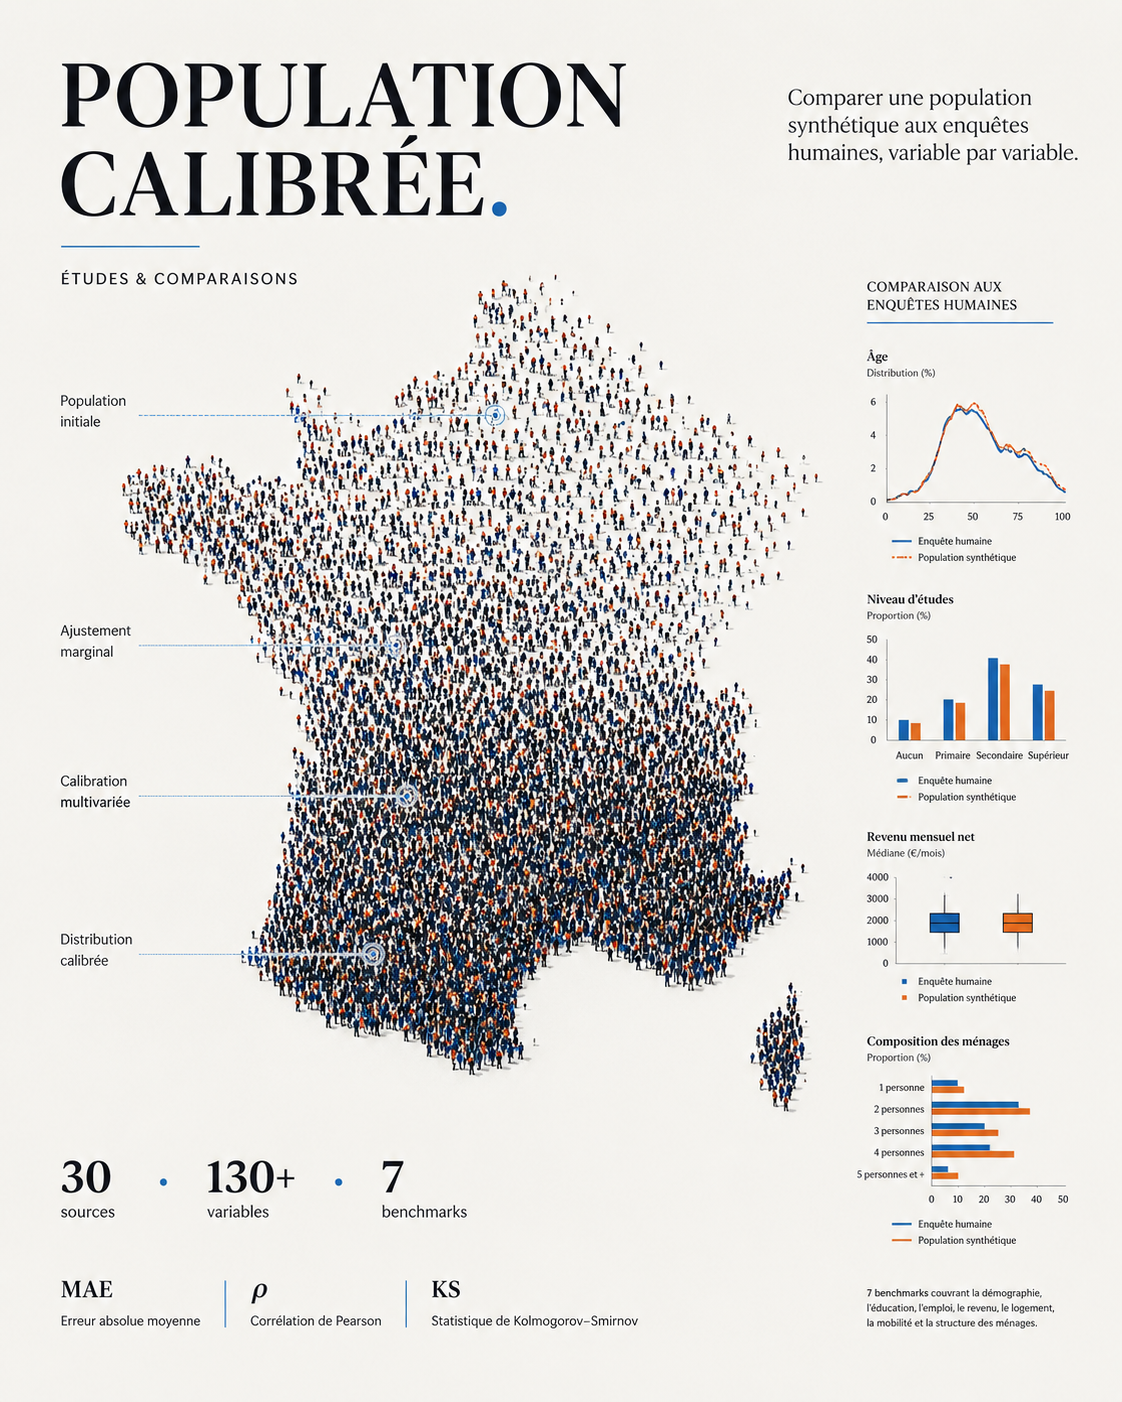
Un panel de personas simulés par IA n'a de valeur que si ses réponses ressemblent à celles d'humains réels. Comment le prouver ? En construisant les personas à partir de données réelles, puis en comparant leurs réponses à des enquêtes existantes. C'est la méthode que nous décrivons ici : une population synthétique calée sur le recensement français, des comportements tirés d'enquêtes de référence, et des benchmarks qui mesurent la convergence avec les études humaines.
Une population calée sur la France, pas sur un modèle
Tout commence par la structure de la population. Nos personas sont au nombre d'un million, définis par des variables structurées — âge, sexe, catégorie socio-professionnelle, territoire, revenu — dont les marges sont calées sur les marges réelles de la population française issues du recensement INSEE. C'est le principe du calage sur marges, formalisé par Deming & Stephan (1940) puis Deville & Särndal (1992) : on ajuste une population simulée pour que ses totaux de bord correspondent aux totaux connus de la vraie population.
Le résultat est direct : quand on tire 1 000 personas au hasard, leur structure socio-démographique est celle de la France — pas celle des données d'entraînement du modèle. C'est la différence fondamentale avec un persona « généré par prompt », qui reflète le groupe majoritaire des données d'entraînement du LLM (Santurkar et al., 2023).
Les profils narratifs de cette population — prénoms, noms, parcours, traits de personnalité — s'appuient sur le jeu de données Nemotron-Personas-France de NVIDIA (Langlais et al., 2026), aligné sur les distributions réelles de la France et construit à partir du recensement 2025 et de fichiers INSEE (prénoms, noms), SIREN et INED.
Des comportements tirés d'enquêtes, jamais inventés
Une population représentative ne suffit pas : encore faut-il que chaque persona se comporte comme la personne qu'il représente. Pour chaque dimension de la vie — pratiques culturelles, sport, voyages, alimentation, numérique, opinions, valeurs — nous construisons des matrices de probabilités par segment : pour chaque persona, chaque comportement a une probabilité d'activation et une distribution d'intensité.
Chaque persona combine au total plus de 130 variables structurées : socio-démographie, comportements,valeurs, opinions, issues de plus de 30 sources de référence, pas d'un modèle génératif (INSEE, CREDOC, ADEME...)
Ces variables couvrent un ensemble de dimensions étendu pour nos personas : Pratiques culturelles, alimentation, valeurs, habitudes de consommation...
Chaque taux a une origine traçable.
Le rôle du modèle de langage est alors strictement limité : il reçoit des faits établis et représentatifs, pour chaque persona.
Les benchmarks : la preuve par la comparaison
Une méthode se juge à ses résultats. Nous comparons systématiquement les réponses de nos personas à des enquêtes humaines existantes, avec des protocoles miroirs : mêmes questions, mêmes options. Deux métriques : le MAE (écart moyen en points de pourcentage) et le ρ de Spearman (corrélation des rangs). La « correspondance » est définie comme 100 − MAE sur l'ensemble des paires comparables.
Exemples de benchmarks réalisés :
| Benchmark |
Référence humaine |
Résultat |
| Bien-être (17 domaines, 34 paires) |
Ipsos Happiness Index 2026 (n = 23 268) |
MAE 11,4-12,1 pts → ≈ 88 % |
| Marques alimentaires (9 enseignes) |
étude marques |
MAE 0,4 pt → 99 % de cohérence individuelle |
| Produits locaux |
Ipsos 2025 (n = 1 097) |
MAE 17,0 pts ; santé 93 %, savoureux 92 % |
| Pratiques culturelles (207 × 7 PCS) |
INSEE FPORSOC23 |
ρ moyen +0,83 (avant calibration : −0,19) |
| Opinion redistribution |
ESS France (n = 20 669) |
KS 0,134 (avant module politique : 0,369) |
| Opinion assistanat |
ESS France (n = 4 112) |
KS 0,116 |
| Santé (13 questions) |
IFOP/MEDEF 2022 (n = 1 008) |
KS moyen 0,191 |
| Motivations → autopartage |
ADEME 2025 |
rejet privé 4-6 %, garanties sans effet |
| Motivations → garde d'enfants |
DREES 2021 + Sénat |
privé 0 % ; ρ = −0,25 solidarité→crèches |
Où la convergence est forte (> 80 %) — et où elle ne l'est pas
La convergence est forte sur les comportements ancrés et les opinions couvertes par un trait. L'enseigne préférée d'un persona correspond à son profil calibré dans 99 % des cas. Sur le bien-être, la correspondance moyenne atteint 88 % — 20 des 34 mesures sont à moins de 10 points d'Ipsos. Sur les pratiques culturelles, la corrélation des rangs avec l'INSEE est de +0,83 : le gradient social est dans le bon sens, un ouvrier de 58 ans en zone rurale et une cadre de 35 ans à Lyon n'ont pas les mêmes pratiques — exactement comme dans la réalité. Sur l'opinion de redistribution, la distribution de nos personas épouse celle des 20 669 répondants français de l'ESS (KS 0,134).
Elle est en revanche faible, et nous le disons, sur deux types de questions. Les perceptions collectives (« les produits locaux sont-ils bons pour la santé ? ») restent décalées : le modèle répond par son sens commun, pas par la norme sociale partagée. Les fréquences déclarées (« au moins une fois par an ») souffrent d'un biais de complaisance — mais les rangs restent bons (ρ lecture 0,96). Et les croisements par sous-groupe à petit échantillon sont instables : nous ne publions que des résultats confirmés à grande échelle.
Une leçon d'honnêteté s'impose : la « correspondance » est une moyenne, pas une promesse par question. Certains domaines sont à moins de 10 points d'Ipsos, d'autres à 30-40 points. Un article qui ne dirait que « 88 % » sans montrer les écarts par domaine serait trompeur — c'est pourquoi nous les indiquons quand ils sont significatifs ou révélateurs des limites.
Ce que ça dit de nos personas
La construction par données bat le prompt. Les matrices calibrées apportent à elles seules +0,31 de corrélation par rapport au LLM seul (ρ 0,52 → 0,83), et un « roleplay naïf » plafonne à 41,2 points de MAE contre 28,2 pour la méthode calibrée.
La convergence est réelle sur les comportements et les opinions couvertes : 99 % (marques), 88 % (bien-être), ρ 0,83 (culture), KS 0,13 (opinion). C'est la preuve que des personas construits sur des données réelles peuvent reproduire des distributions humaines — conditionnellement à un calage démographique et comportemental explicite, comme le montre la littérature (Argyle et al., 2023).
Les limites sont structurelles, et nous les documentons : perceptions collectives, complaisance sur les fréquences, variance des petits sous-groupes.
Et la règle d'or, en toutes lettres : un persona synthétique ne remplace pas un utilisateur réel. C'est un point représentatif d'une distribution, pas une prédiction individuelle. Mirubiki est un outil d'exploration et de benchmark : il ne remplace pas un panel mais complète un arsenal d'étude et de test.
Références
Argyle et al. (2023, arXiv:2209.06899) ; Aher et al. (2023, arXiv:2208.10264) ; Horton (2023, NBER 31122) ; Santurkar et al. (2023, arXiv:2303.17548) ; Bisbee et al. (2024, Political Analysis 32(4)) ; Deming & Stephan (1940) ; Deville & Särndal (1992).
À lire aussi : Les biais des personas IA · Des personas qui répondent aux sondages
Mirubiki interroge 25 profils représentatifs de la population française en quelques minutes — testez votre idée.