
Fiabilité des personas synthétiques
Un persona synthétique ne se juge pas sur une démonstration. Cette page rassemble ce que nous mesurons, face à quoi, et ce qui reste à prouver. Elle est mise à jour à chaque nouveau benchmark.
Un persona généré par IA n'est pas un Français moyen
Un modèle de langage interrogé sans cadre ne décrit pas la population française. Il décrit son propre centre de gravité, c'est-à-dire le groupe majoritaire de ses données d'entraînement. Trois biais reviennent dans la littérature, et nous les avons retrouvés sur nos propres sorties.
- Aplatissement. Les réponses convergent vers le mode. Les positions extrêmes, qui portent souvent l'information utile, s'effacent.
- Complaisance. Les réponses acquiescent. Sur les questions de perception générale, l'erreur moyenne de complaisance atteint environ 28 points.
- Sous-dispersion. Les répondants simulés sont trop d'accord entre eux. Le désaccord réel, qui est une donnée, disparaît.
Notre première version, un pipeline sans construction préalable, produisait un gradient social de pratiques culturelles négativement corrélé à la réalité INSEE : corrélation de rang de -0,19 sur cinq pratiques. Autrement dit, un classement parfois inversé.
Notre méthode : une population construite, pas un prompt
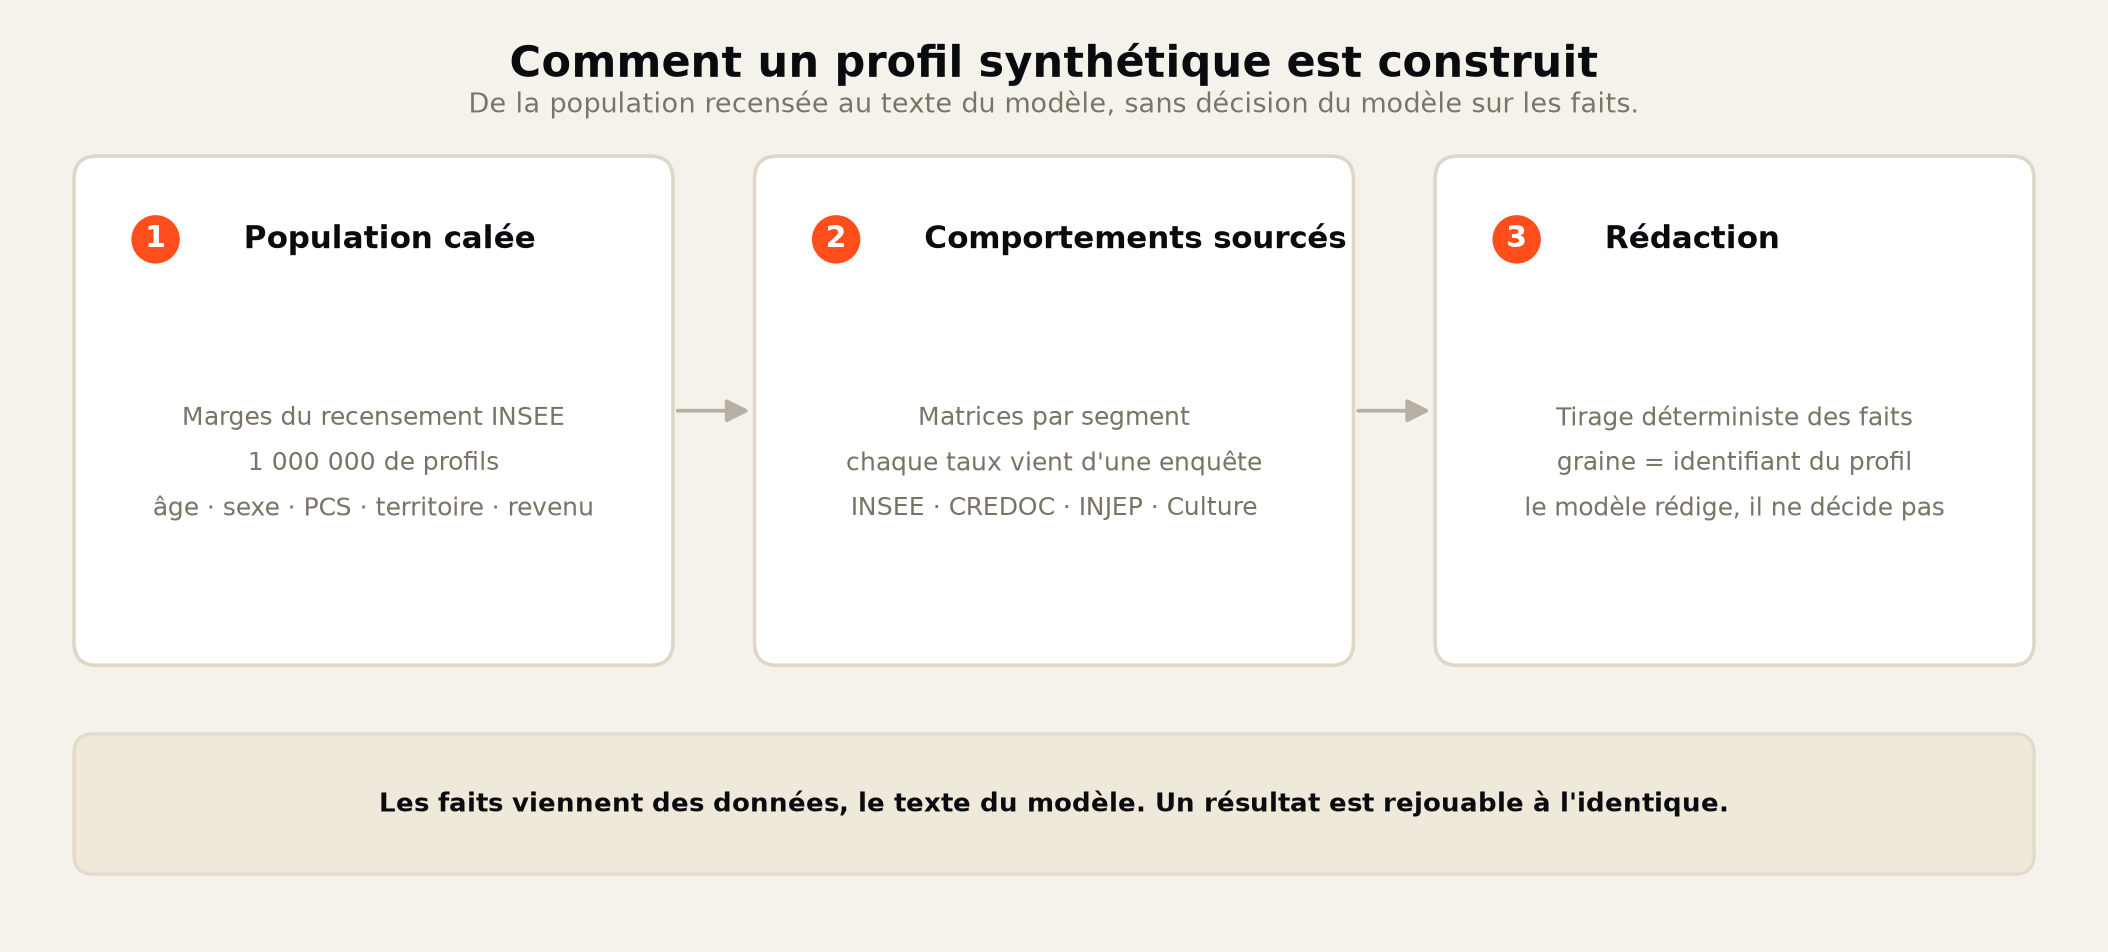
Un persona généré par un prompt libre reflète surtout les données d'entraînement du modèle. Nous procédons dans l'autre sens : la population d'abord, les comportements ensuite, le texte en dernier.
- Couche 1, la population. Un million de profils dont les marges (âge, sexe, catégorie socio-professionnelle, territoire, revenu) reproduisent celles du recensement INSEE. La technique est le calage sur marges, décrit par Deming et Stephan en 1940 et formalisé par Deville et Särndal en 1992. Le détail des variables est sur personas synthétiques.
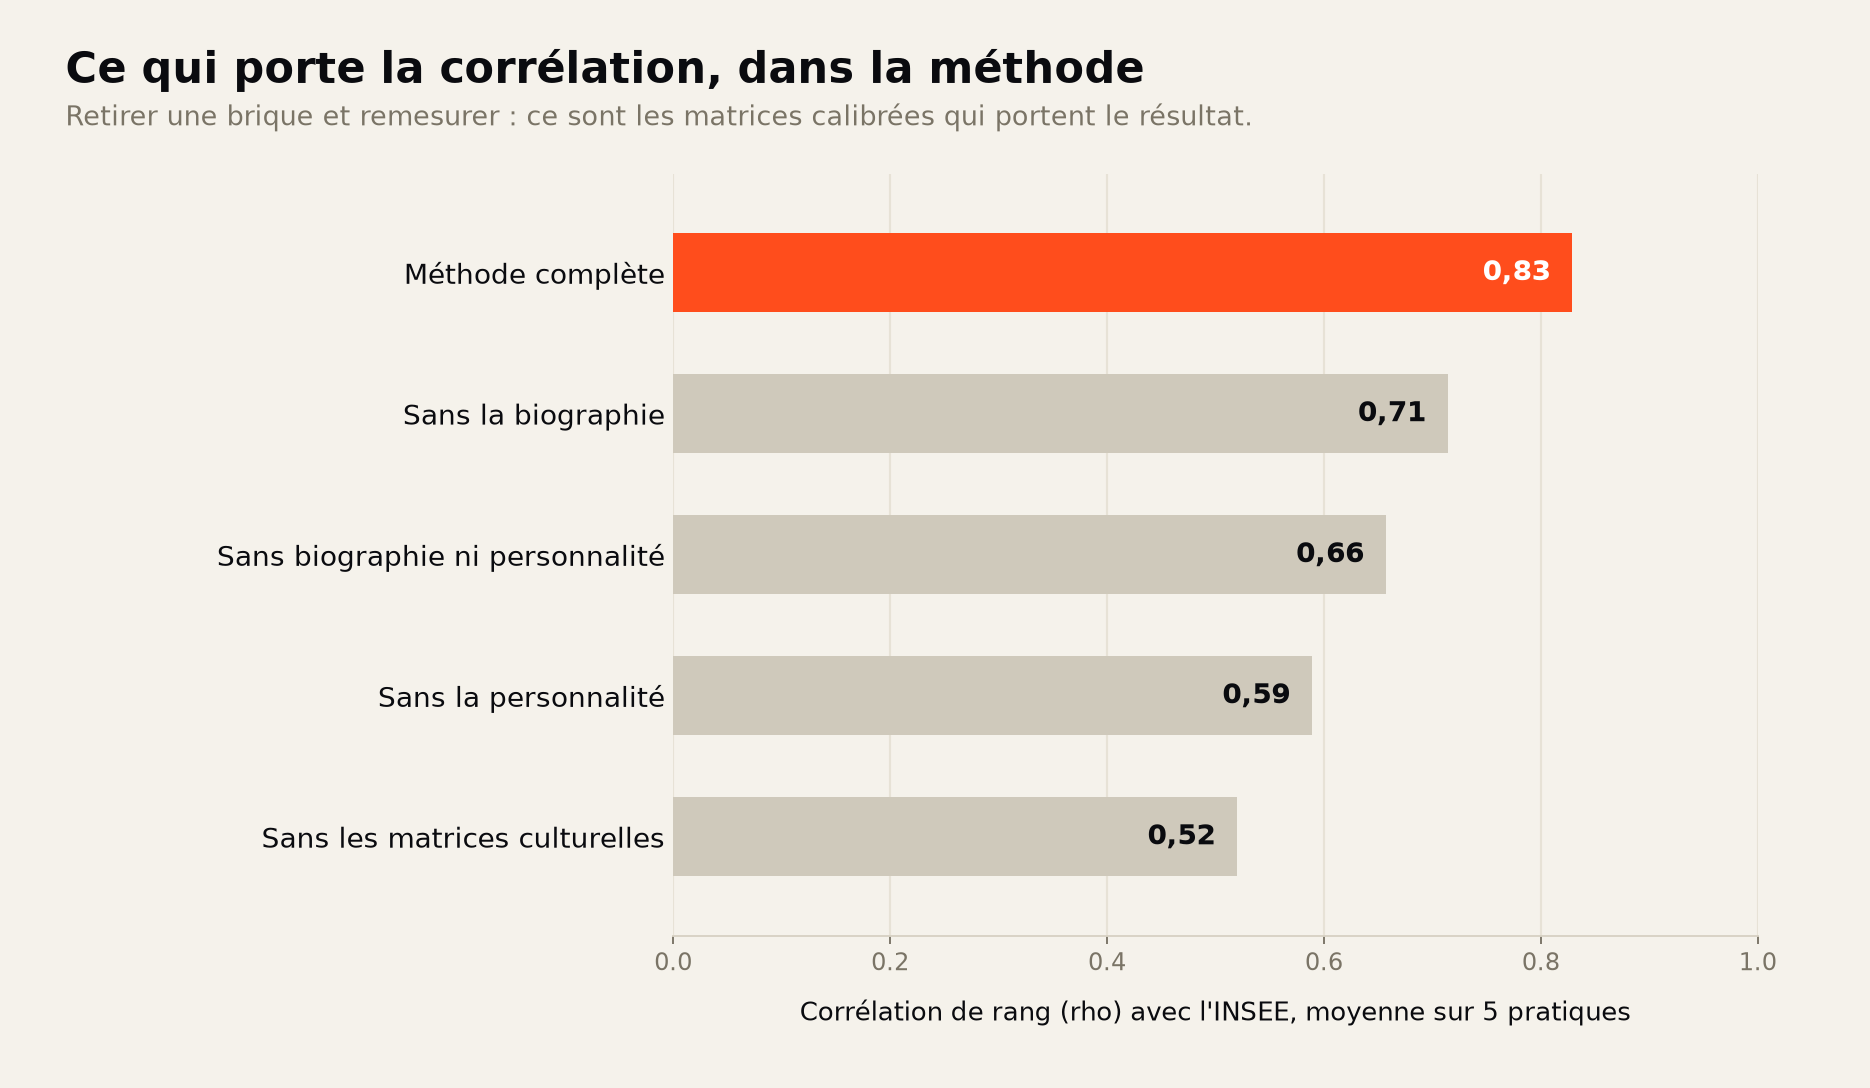
- Couche 2, les comportements. Des matrices par segment, calibrées sur des enquêtes de référence et non sur un modèle génératif. Chaque taux de pratique, chaque opinion, vient d'une enquête nommée.
- Couche 3, le tirage. Chaque profil tire ses faits de façon déterministe, la graine étant dérivée de son identifiant. Le modèle de langage rédige ensuite les réponses : il ne décide d'aucun fait.
Ce que nous mesurons, face aux enquêtes humaines
Une méthode se juge à ses résultats. Nous comparons systématiquement nos réponses à des enquêtes humaines existantes, posées avec les mêmes questions et les mêmes options, et nous publions l'écart.
| Domaine | Référence humaine | Résultat | Nature de la comparaison |
|---|---|---|---|
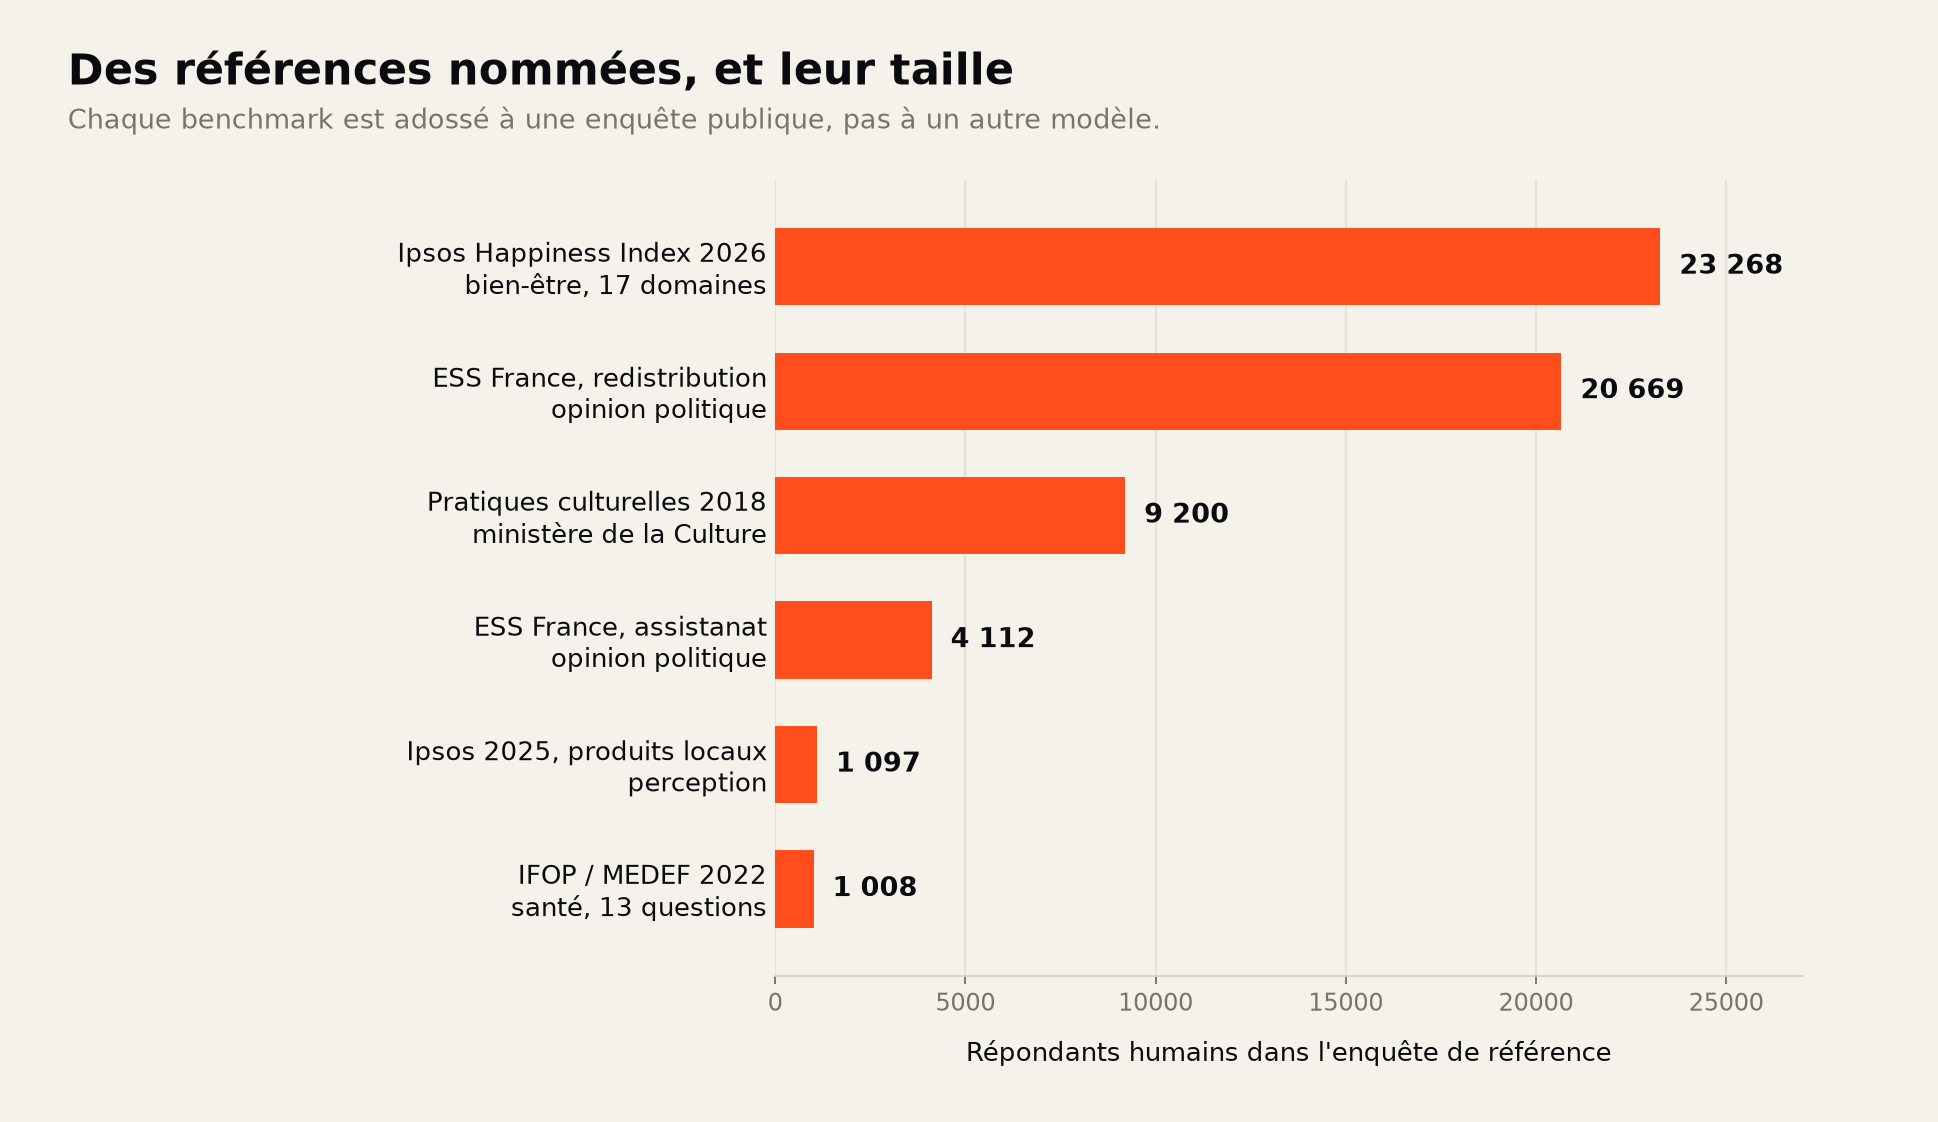
| Bien-être (17 domaines) | Ipsos Happiness Index 2026, n = 23 268 | MAE 11,4 à 12,1 points, environ 88 % de correspondance | contrôle externe |
| Marques alimentaires (9 enseignes) | EY 2026 | MAE 0,4 point, 99 % de cohérence | contrôle externe |
| Produits locaux | Ipsos 2025, n = 1 097 | MAE 17,0 points | source commune (fidélité) |
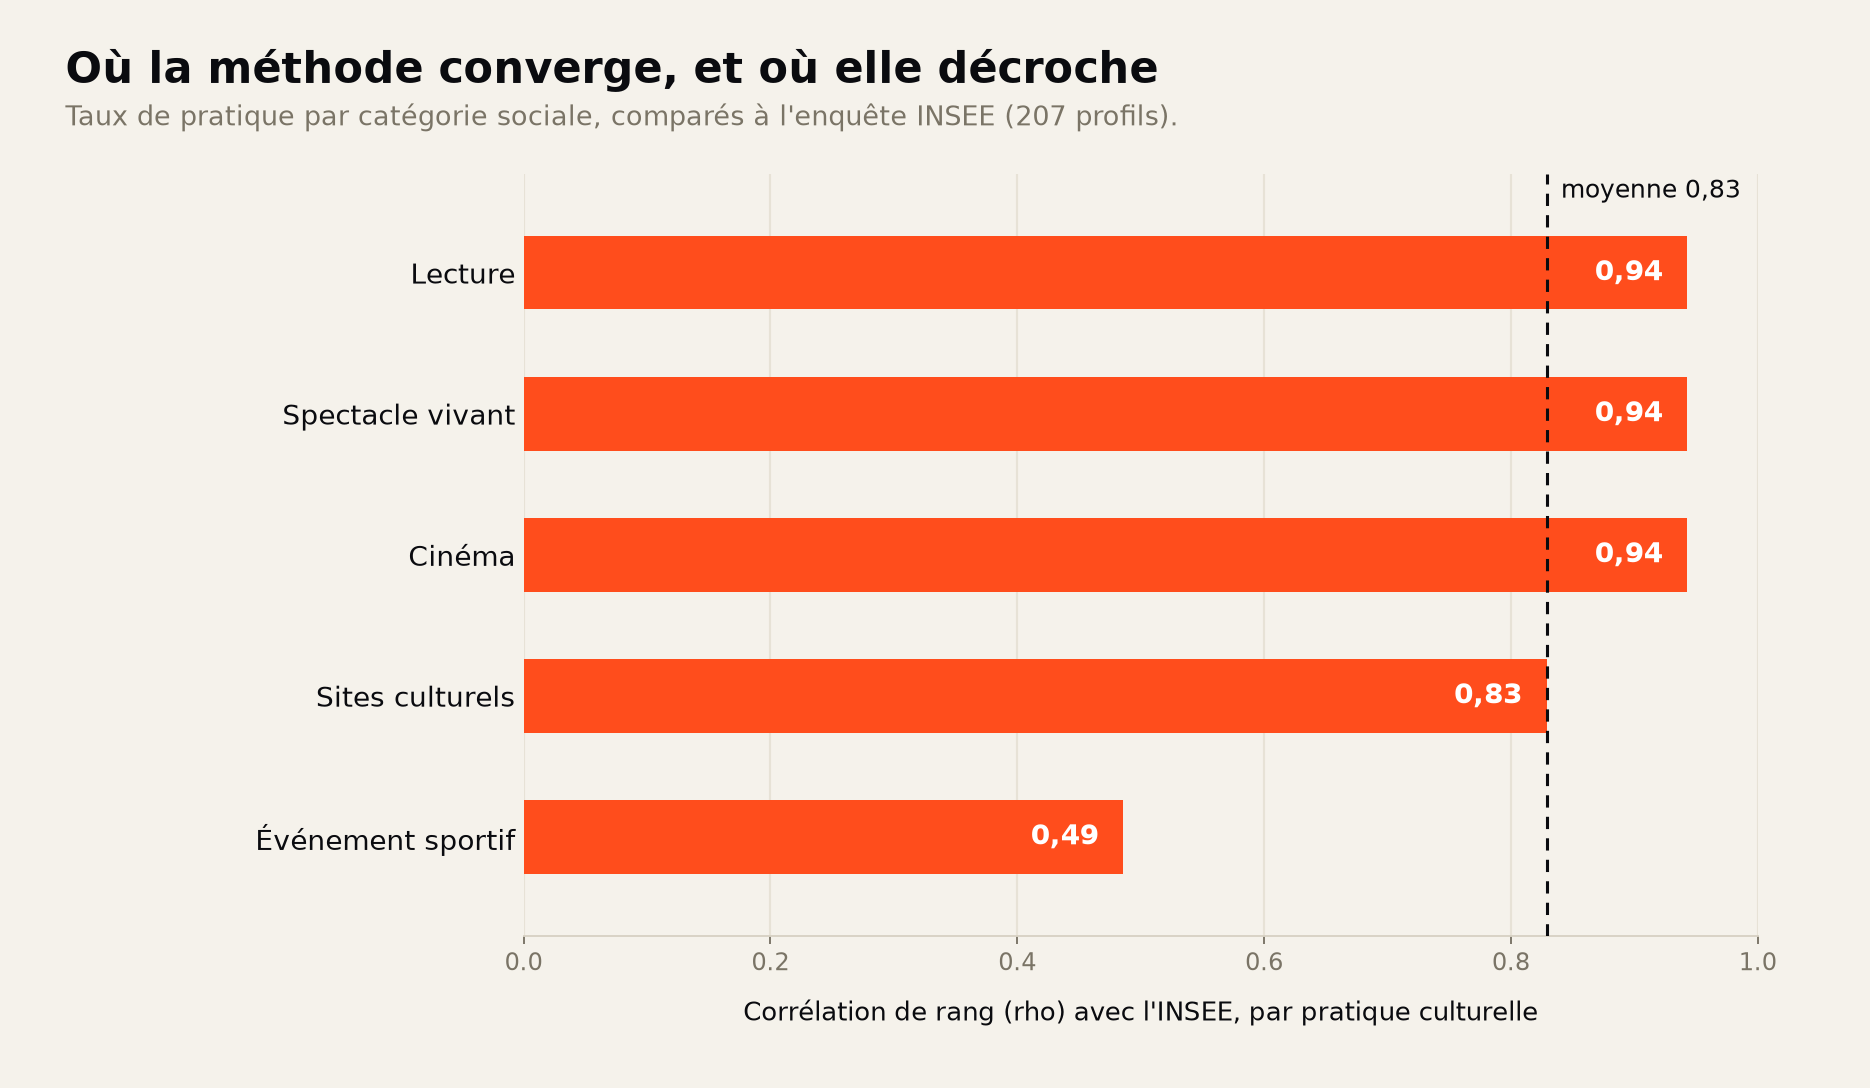
| Pratiques culturelles (207 profils, 7 PCS) | INSEE FPORSOC23 | corrélation de rang +0,83 ; avant calibration -0,19 | source commune (fidélité) |
| Opinion, redistribution | ESS France, n = 20 669 | écart de distribution 0,134 ; avant module politique 0,369 | partiellement distincte (vagues non calibrées) |
| Opinion, assistanat | ESS France, n = 4 112 | écart de distribution 0,116 | source commune (fidélité) |
| Santé (13 questions) | IFOP / MEDEF 2022, n = 1 008 | écart de distribution moyen 0,191 | contrôle externe |
| Autopartage | ADEME 2025 | rejet du privé 4 à 6 % | contrôle externe |
| Garde d'enfants | DREES 2021 | recours au privé 0 % ; corrélation de rang -0,25 | contrôle externe |
Nature de la comparaison : « contrôle externe » signifie que l'étude de référence n'a jamais servi à caler le modèle, c'est donc un test. « Source commune » signifie qu'elle a servi à le caler : la comparaison mesure alors la fidélité au jeu de calibration, ce qui reste une information, mais ne prouve pas le transfert. Cette distinction n'était pas faite dans les versions précédentes du tableau, et elle change la lecture de deux lignes.
La dispersion : le désaccord est-il reproduit ?
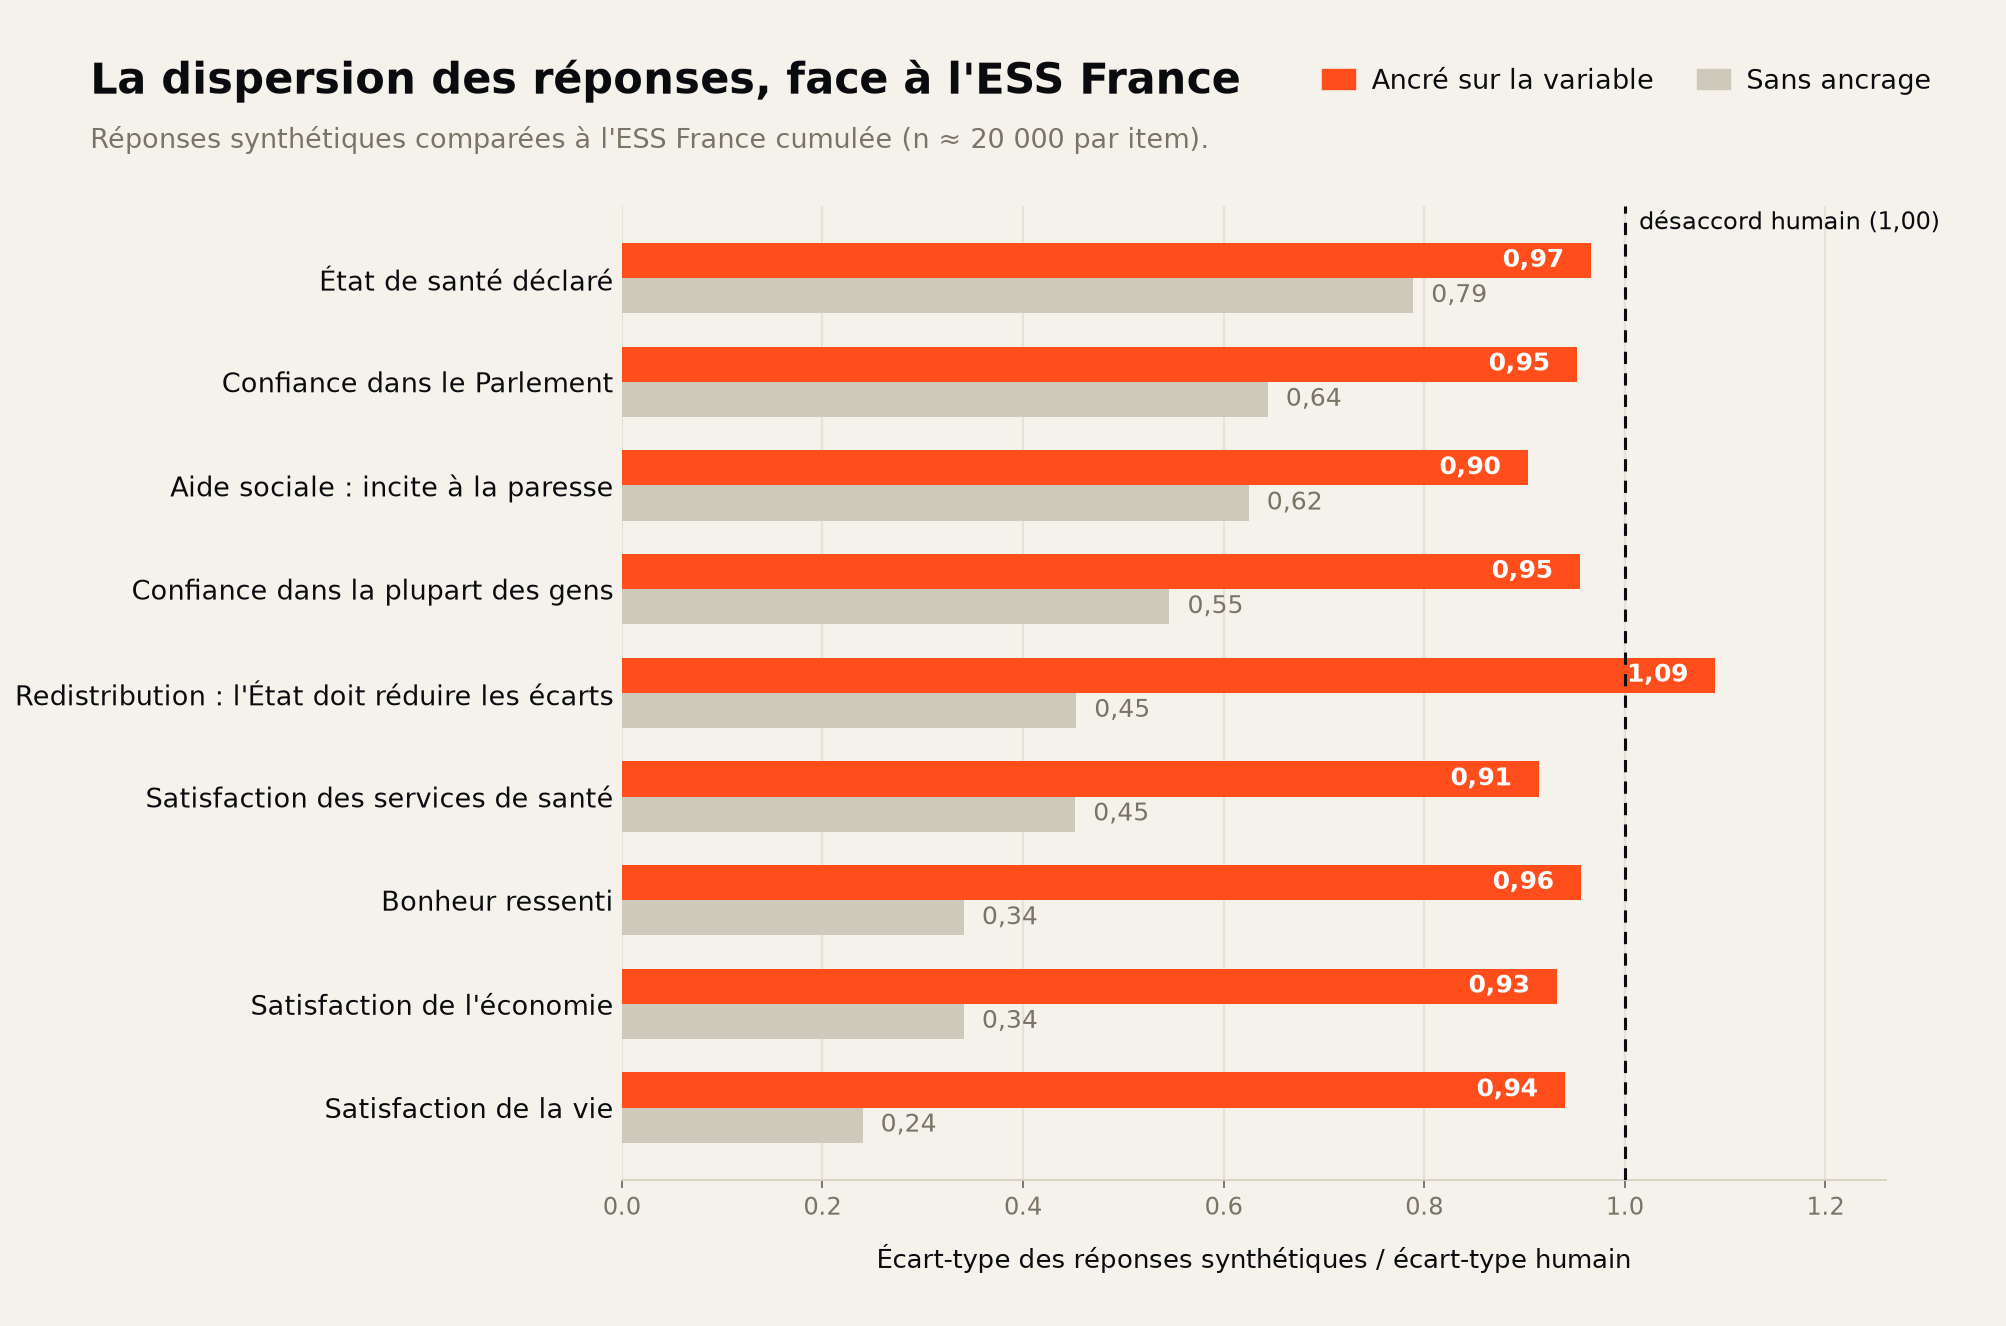
C'est le défaut central du domaine. Les répondants simulés sont trop d'accord entre eux, et cette sous-dispersion s'entend moins qu'un biais de moyenne. Nous mesurons donc le rapport entre l'écart-type de nos réponses et celui des humains, item par item, contre l'ESS France cumulée (environ 20 000 répondants par item). Un rapport proche de 1 signifie que le désaccord de la population est reproduit.
- Avec une variable ancrée, sur les items d'attitude, le rapport va de 0,90 à 1,14. Le désaccord mesuré est celui des humains.
- Sans ancrage, il s'effondre : de 0,24 à 0,79.
- Trois items restent sous-dispersés malgré l'ancrage : iphlppl 0,62, imwbcnt 0,76, wrclmch 0,73.
Où la convergence est forte, et où elle ne l'est pas
Côté fort, les comportements ancrés et les opinions portées par un trait : l'enseigne alimentaire préférée atteint 99 % de cohérence, le bien-être 88 %, les pratiques culturelles une corrélation de rang de 0,83, la redistribution un écart de distribution de 0,134.
Côté faible, et nous le disons : les perceptions collectives, c'est-à-dire ce que les gens pensent qu'un sujet pense, les fréquences déclarées que la complaisance surestime, et les croisements par sous-groupe à petit échantillon.
Ce que nous ne prouvons pas encore
- Le banc hors échantillon. Le tableau ci-dessus sépare désormais les contrôles externes des sources communes. Pour les items d'opinion, nous avons mesuré l'écart séparément sur les vagues ESS qui ont servi à calibrer et sur celles qui n'y ont jamais servi : la dégradation reste faible, de l'ordre de deux centièmes, et trois items font même mieux, ce qui relève du bruit d'échantillonnage. Mais ces vagues datent de 2002 à 2006 et l'opinion a bougé depuis, donc l'écart mêle le transfert du modèle au déplacement de l'opinion. Un test vraiment vierge demanderait une enquête contemporaine non utilisée pour calibrer : nous n'en avons pas encore pour les pratiques culturelles ni pour les produits locaux.
- Les intentions d'achat. Les items d'attitude de l'ESS mesurent une opinion déclarée, pas un acte.
- La dispersion par segment. Elle est mesurée globalement. Nous ne savons pas encore si elle se dégrade sur certains sous-groupes.
Les sources et la reproductibilité
Les enquêtes de référence, leur année et leur taille figurent dans le tableau ci-dessus. Elles sont publiques. Nos réponses, elles, sont rejouables : le tirage est déterministe, donc un même profil produit la même réponse sur n'importe quelle machine. La méthode est auditable, ce n'est pas une boîte noire.
Les travaux qui ont servi de base ou de garde-fou : Argyle et al. 2023, Bisbee et al. 2024, Santurkar et al. 2023, Deming et Stephan 1940, Deville et Särndal 1992, Bourdieu 1979.
Un persona synthétique ne remplace pas un utilisateur réel. C'est un point représentatif d'une distribution, jamais une prédiction individuelle.
Tester la méthode sur votre questionnaire
Décrivez votre idée, choisissez qui vous répond, et lisez les résultats en quelques minutes. Le plan gratuit permet 5 sondages par mois, jusqu'à 25 profils par sondage.
Interroger un panel synthétique
À lire aussi : Personas synthétiques · Étude de marché par IA · Sondages par IA · La méthode derrière nos personas · Personas IA et bien-être